


Provozovatelé internetových stránek by brzy mohli získat jednodušší způsob, jak zabránit využívání svého obsahu k trénování generativní umělé inteligence. Společnosti Google, Microsoft, OpenAI a Anthropic podpořily společné technické řešení, které má sjednotit pravidla pro využívání webového obsahu. Novinka by mohla výrazně usnadnit práci vydavatelům i dalším tvůrcům, její zavádění však bude postupné.
Technologické společnosti 30. října oznámily podporu návrhu, který umožní majitelům webových stránek vyjádřit nesouhlas s využíváním jejich obsahu k trénování AI prostřednictvím jediného nastavení. Dosud museli provozovatelé webů spravovat pravidla pro jednotlivé společnosti samostatně, protože každá využívá vlastní automatizované nástroje pro shromažďování dat. Nový přístup má tuto administrativu výrazně zjednodušit.
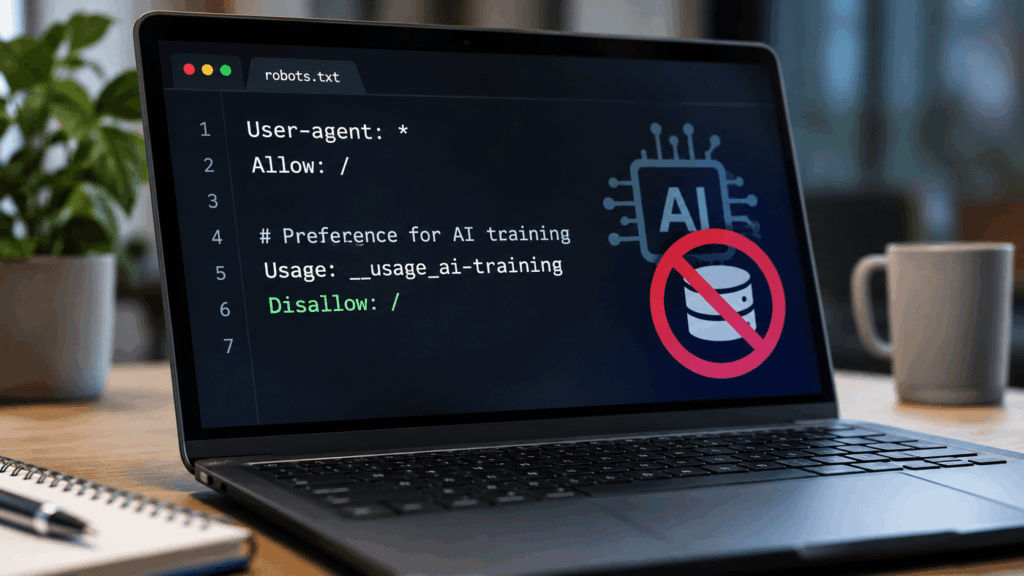
Základem řešení bude soubor robots.txt, který už dnes slouží k nastavování pravidel pro automatizované procházení webových stránek. Google oznámil, že podpoří společný signál umožňující vyjádřit nesouhlas s trénováním AI napříč zapojenými poskytovateli. Majitelé webů tak nebudou muset vytvářet samostatná omezení pro každou technologickou firmu.
Jedno nastavení má usnadnit ochranu webového obsahu
Navrhované řešení využívá označení __usage_ai-training, které se vloží do souboru robots.txt. Provozovatel webu následně pomocí běžných pravidel určí, zda dovoluje využívat svůj obsah k trénování generativních modelů. Omezení bude možné nastavit pro celý web nebo jen vybrané stránky a adresáře. Návrh přitom nevyžaduje zavádění nových technických příkazů, ale využívá již existující systém.
Důležité je také rozlišení mezi trénováním umělé inteligence a běžným internetovým vyhledáváním. Vydavatelé mohou chtít, aby jejich články zůstaly dostupné ve výsledcích vyhledávačů, ale zároveň nesouhlasit s jejich využíváním jako trénovacích dat. Microsoft proto představil také samostatné nastavení pro využívání obsahu při vytváření odpovědí umělé inteligence. Provozovatelé tak budou moci rozhodovat o různých způsobech použití svých materiálů nezávisle na sobě.
Nová pravidla se začnou zavádět v roce 2027
Přestože návrh získal podporu významných technologických společností, zatím nejde o oficiálně schválený mezinárodní standard. Google počítá se zavedením v roce 2027, zatímco Microsoft plánuje podporu od 1. února 2027. OpenAI chce nové řešení zavést v následujících měsících a Anthropic již na jeho implementaci pracuje. Dosavadní pravidla jednotlivých společností přitom zůstanou zachována.
Nový mechanismus však nebude představovat automatickou ochranu před veškerým využíváním obsahu umělou inteligencí. Půjde o dobrovolně respektovaný signál, jehož účinnost bude záviset na konkrétních poskytovatelích. Nebude také zpětně měnit podmínky pro data, která firmy získaly dříve. Přesto může jít o důležitý krok pro vydavatele, novináře a další tvůrce, kteří dlouhodobě požadují větší kontrolu nad využíváním svých materiálů při vývoji generativní AI.